
LLM-Bewertung für SWAO
Die LLM-Bewertung für SWAO beantwortet eine praktische Frage: Welches LLM erledigt die Bewertungsarbeit von SWAO für meine Anwendung am besten? Sie nimmt eine Ihrer Anwendungen, für die bereits eine abgeschlossene Anwendungsbewertung vorliegt, und führt diese Bewertung mit 2 bis 5 verschiedenen Paaren aus LLM-Konnektor und Modell erneut aus, den sogenannten Legs. SWAO zeichnet jeden LLM-Aufruf in jedem Leg auf und vergleicht die Modelle nach Antwortqualität, struktureller Zuverlässigkeit, Geschwindigkeit, Kosten, Reasoning-Verhalten und Sicherheitsverhalten. Sie erhalten einen Vergleich nebeneinander, ein gewichtetes Gesamtranking und ein Befundprotokoll.
Die beiden Bewertungen sind bewusst getrennt:
| Anwendungsbewertung | LLM-Bewertung für SWAO | |
|---|---|---|
| Was variiert | Die Anwendung | Das Modell (2 bis 5 Legs) |
| Was fest bleibt | Ein Modell | Eine Anwendung mit abgeschlossener Anwendungsbewertung |
| Ergebnis | Signale, Compliance-Bewertungen, 7R-Empfehlung | Modellvergleich nach Dimensionen, Gesamtranking, Befundprotokoll |
Ein Lauf der LLM-Bewertung schreibt nie in die eigenen Daten der Anwendung unter apps/<id>/wsp/, und die Publikation der Anwendung führt keine Artefakte der LLM-Bewertung auf.
Die LLM-Bewertung für SWAO ist keine Souveränitätsbewertung eines KI-Anbieters, den Ihr Auftraggeber in eigenen Produkten einsetzen möchte. Für diese Frage nutzen Sie das Rahmenwerk LLM Selection oder das Rahmenwerk AI 10 Pillars im Rahmen einer normalen Bewertung.
Was Sie damit tun können
- Das Modell für ein Projekt wählen. Eine Cloud-API mit einem selbst betriebenen Modell (etwa über Ollama oder einen internen vLLM-Endpunkt) an Ihrer echten Arbeitslast vergleichen, bevor Sie sich für die übrigen Anwendungen festlegen.
- Prüfen, ob das Urteil vom Modell abhängt. Manche Modelle kommen bei derselben Eingabe zu einem anderen 7R- oder Compliance-Ergebnis. Der Vergleich zeigt die Übereinstimmung der Urteile zwischen den Legs.
- Kosten und Laufzeit planen. Gesamtkosten, Latenz und Gesamtlaufzeit je Modell an einer Anwendung sehen, die Sie kennen.
- Zuverlässigkeit beurteilen. Abgebrochene Läufe, Wiederholungen, Ratenlimit-Vorfälle, abgeschnittene und nicht auswertbare Antworten zählen.
- Sicherheitsverhalten prüfen. Sehen, ob ein Modell Redaktionsmarker verändert, personenbezogene Daten wiedergegeben, auf nicht existierende Dateien verwiesen, die Antwort verweigert oder Anzeichen von Prompt Injection gezeigt hat.
Was Sie bereitstellen
- Eine abgeschlossene Anwendungsbewertung der Ziel-App. Ohne sie bricht der Lauf ab und weist darauf hin, zuerst
swao assess --app <id>auszuführen. Haben sich Quellcode oder Eingaben der App seit diesem Lauf geändert, läuft die LLM-Bewertung trotzdem und vermerkt die Änderung im Manifest. - Zwei bis fünf Legs im Block
llm_assessmentder.swao.ymlauf Workspace-Ebene (nicht in der Datei der App). - Zugangsdaten für jeden Konnektor im SWAO-Credential-Store (
swao credential set <schlüssel>), nie in YAML. - Installierte Rahmenwerkskataloge für jedes Regime in
assessment.regimes_activeder App. Der Compliance-Pass ist die größte LLM-Arbeitslast; ein fehlender Katalog würde die Legs unvollständig machen, deshalb weist SWAO darauf hin.
Konfiguration
# <workspace>/.swao.yml
llm_assessment:
  legs:
    - connector: openrouter
      model: anthropic/claude-sonnet-4
      primary: true
    - connector: openrouter
      model: deepseek/deepseek-v4-flash
    - connector: ollama
      model: llama3.3
  execution: serial        # oder parallel (Standard: serial)
  repeat: 1                # Läufe je Leg, 1 bis 10 (Standard: 1)
  weights:                 # Gewichte des Gesamtergebnisses; auf Summe 1 normiert
    quality: 0.5
    reliability: 0.2
    performance: 0.15
    cost: 0.15
security: 0.1| Schlüssel | Bedeutung |
|---|---|
legs | 2 bis 5 Einträge. connector ist eine LLM-Gateway-Konnektor-ID; model ist optional (ohne Angabe gilt das Standardmodell des Konnektors) |
primary | Höchstens ein Leg; ist keines markiert, gilt das erste Leg als primär. Das primäre Leg ist die Referenz für Übereinstimmungsmetriken |
execution | serial (Standard; schont Ratenlimits und liefert unverfälschte Latenzen) oder parallel |
repeat | Anzahl der Wiederholungen je Leg. Bei mehr als einer zeigt der Vergleich Median und Streuung |
weights | Relative Gewichte für Qualität, Zuverlässigkeit, Performance, Kosten und Sicherheit. Die Standardwerte stehen oben; SWAO normiert sie auf die Summe 1 und veröffentlicht die angewandten Gewichte mit dem Ergebnis |
keep_leg_wsp | true behält die temporären Leg-Workspaces zur Fehlersuche (Standard: nach der Metrikextraktion verworfen) |
interpretation | Ergänzt eine vom LLM verfasste Interpretation des Gesamtvergleichs |
default_app | Standard-Ziel-App für die TUI |
Konnektoren
Konnektoren werden aus den mitgelieferten LLM-Gateway-Vorlagen und aus wsp/inputs/llm-gateway/ im Workspace ermittelt. Mitgelieferte Vorlagen sind unter anderem:
| Konnektor-ID | Anbieter | Protokoll | Deklarierte Datenresidenz |
|---|---|---|---|
anthropic | Anthropic Claude | anthropic-messages | US/EU, abhängig von der Kontokonfiguration |
openai | OpenAI | openai-chat | US (globale Endpunkte) |
openrouter | OpenRouter | openai-chat | global |
bedrock | Amazon Bedrock | bedrock | die konfigurierte AWS-Region |
ollama | Ollama (lokal) | ollama | lokal |
vllm-generic | Generischer OpenAI-kompatibler Endpunkt (vLLM, interner Hub) | openai-chat | selbst betrieben |
open-llm | Entfernter OpenAI-kompatibler Endpunkt (gehosteter GenAI-Hub oder vLLM) | openai-chat | vom Anbieter festgelegt |
Für einen eigenen Konnektor kopieren Sie _template.yaml nach wsp/inputs/llm-gateway/. Siehe LLM-Gateway-Konnektoren erstellen.
Ablauf eines Laufs
- Vorbedingung. SWAO prüft, ob eine abgeschlossene Anwendungsbewertung vorliegt, und hält die Hashwerte von Quellcode und Eingaben der App fest.
- Legs. Für jedes Leg kopiert SWAO Workspace-Konfiguration, Eingaben und App in einen temporären Leg-Workspace und führt dort mit Konnektor und Modell des Legs eine vollständige Anwendungsbewertung aus. Der LLM-Antwortcache ist für jedes Leg abgeschaltet, damit kein Leg die Antworten eines anderen wiederverwendet. Jeder LLM-Aufruf wird aufgezeichnet.
- Challenge (sofern verfügbar). Jedes Leg kann zusätzlich die adversariale Challenge-Prüfung gegen die eigenen Befunde ausführen. Der Befehl
swao challengeist eine Enterprise-Funktion; in anderen Stufen oder bei einem Fehler läuft das Leg ohne Challenge-Daten weiter, und die Challenge-Metriken bleiben leer. - Vergleich. Aus den Aufrufprotokollen werden die Metriken extrahiert, die Leg-Workspaces verworfen, und die Vergleichs-Engine bildet Dimensionsgruppen, Sichten je Pass und das gewichtete Gesamtergebnis.
- Befundprotokoll und Publikationsmodell. Auffällige Beobachtungen landen in einem Befundprotokoll, und für
swao publish --llmwird ein Publikationsmodell vorbereitet.
Bei genau 2 Legs gibt es keine Mehrheit. Die Übereinstimmung wird dann nur gegen das primäre Leg gemessen, und das Ergebnis ist als direkter Zweiervergleich („head-to-head“) gekennzeichnet. Ab 3 Legs greifen die Mehrheits- und Konsensmetriken.
Was gemessen wird
SWAO misst 33 Metriken in 9 Gruppen (Metrikkatalog Version 1.2.0). Als neutral gekennzeichnete Metriken dienen nur der Information und fließen nie in die Bewertung ein.
| Gruppe | Metriken |
|---|---|
| Qualität, Inhalt | Urteil geliefert, Übereinstimmung der Urteile, Anteil belegter Signale, Nachweise je Signal, Vollständigkeit des Berichts, Übereinstimmung der Signale |
| Qualität, Struktur | Auswertbarkeit, Schemakonformität, leere oder unbrauchbare Antworten |
| Performance | Latenz p50 und p95, Durchsatz, Gesamtlaufzeit |
| Kosten | Gesamtkosten (USD), Reasoning-Anteil der Ausgabe, Prognose gegenüber Ist |
| Zuverlässigkeit | nicht beendet, Wiederholungen, Ratenlimit-Vorfälle, abgeschnittene Antworten |
| Reasoning | Reasoning-Tokens |
| Sicherheit | Verweigerungen, veränderte Redaktionsmarker, unbelegte Dateiverweise, Wiedergabe personenbezogener Daten, Anzeichen von Prompt Injection |
| Metadaten | Kontextlänge, maximale Ausgabetokens, Eingabe- und Ausgabepreis je Million Tokens |
| Challenge | Dialogschritte der Challenge, unvollständige Challenge, Dauer der Challenge |
Der Vergleich ist relativ innerhalb des Laufs. SWAO verwendet keine externen Benchmark-Werte und kein „goldenes“ Referenzurteil.
Schritt für Schritt (CLI)
Stellen Sie sicher, dass für die App eine abgeschlossene Anwendungsbewertung vorliegt:
bashswao assess --app app-crm-01Ergänzen Sie den Block
llm_assessmentin der.swao.ymldes Workspace und hinterlegen Sie die Zugangsdaten für jeden Konnektor.Führen Sie die LLM-Bewertung aus:
bashswao assess --type llm --app app-crm-01 # Legs ohne Playwright-Crawl swao assess --type llm --app app-crm-01 --no-crawlPublizieren Sie das Ergebnis oder erstellen Sie einen Bericht:
bashswao publish --llm swao report --type llm --format pdf # PDF ab Consultant
Schritt für Schritt (TUI)
- Starten Sie
swao, wählen Sie 3 Run Assessment und dann [4] LLM Assessment for SWAO. - Select Application. Die Auswahl listet nur Apps mit abgeschlossener Anwendungsbewertung.
- Select LLM Providers. Wählen Sie 2 bis 5 Konnektoren und für jeden ein Modell oder eine eigene Modell-ID.
- Connectivity check. SWAO testet jeden Konnektor, bevor Tokens verbraucht werden.
- Review Configuration. Prüfen Sie Legs, Ausführungsmodus und Wiederholungen.
- Running. Der Fortschritt wird je Leg angezeigt.
- Complete. Die Ergebnistabelle zeigt Vergleich und Ranking.
Was Sie erhalten
Die Ergebnisse der LLM-Bewertung liegen auf Workspace-Ebene, getrennt von den Daten der App:
<workspace>/llm-assessments/swao/
+-- latest.txt                       Verweis auf den jüngsten Lauf
+-- <zeitstempel>/
    +-- calls/
    |   +-- <leg-id>.ndjson           aufgezeichnete LLM-Aufrufe eines Legs
    |   +-- <leg-id>/passes/          aus dem Leg übernommene Ergebnisse je Pass
    |   +-- <leg-id>/challenge-results.json      wenn die Challenge lief
    +-- comparison/
    |   +-- comparison.json           Dimensionsgruppen, Gesamtergebnis, Sichten je Pass und Challenge
    |   +-- publication-model.json    Eingabe für die HTML-Publikation
    +-- manifest.yaml                 Legs, Hashwerte, Ausführungsmodus, angewandte Gewichte
    +-- findings.yaml                 Befundprotokoll
    +-- log.ndjson                    Laufprotokoll
Leg-IDs haben die Form <konnektor>--<modell>, zum Beispiel ollama--llama3.3.
Lizenzstufe
Die LLM-Bewertung läuft in allen Stufen: Community, Consultant und Enterprise (llm-assessment: community im Register der Funktionsfreigaben). Ihre HTML-Publikation, swao publish --llm, benötigt mindestens Consultant (html-report, wie jede HTML-Publikation). Der Challenge-Teil jedes Legs benötigt den Enterprise-Befehl swao challenge, ein PDF-Bericht mindestens Consultant.
Grenzen
- Kosten. Jedes Leg ist eine vollständige Anwendungsbewertung. Fünf Legs kosten ungefähr fünf Bewertungen, zuzüglich Wiederholungen. Beginnen Sie mit 2 oder 3 Legs an einer kleinen Anwendung.
- Keine gepaarten Stichproben. Nach dem ersten LLM-gestützten Pass laufen die Prompt-Ketten der Legs auseinander, weil spätere Prompts frühere Ausgaben enthalten. Aggregate je Lauf und Ergebnisvergleiche sind belastbar; Vergleiche einzelner Aufrufe zwischen Legs sind nur ein Hinweis.
- Paralleler Modus verfälscht Latenzen. Mischen Sie beim Latenzvergleich keine seriellen und parallelen Läufe.
- Deklarierte Datenresidenz ist eine Eingabe, kein Urteil. Der
sovereignty-Block jeder Konnektordatei gibt wieder, was dessen Autor angegeben hat. Prüfen Sie die Auftragsverarbeitungsbedingungen des Anbieters. - Challenge-Daten liegen nur vor, wo der Challenge-Befehl verfügbar ist und Challenge-Agenten konfiguriert sind.
Live-Beispielbericht
Eine Publikation der LLM-Bewertung mit dem Vergleich mehrerer Modelle:
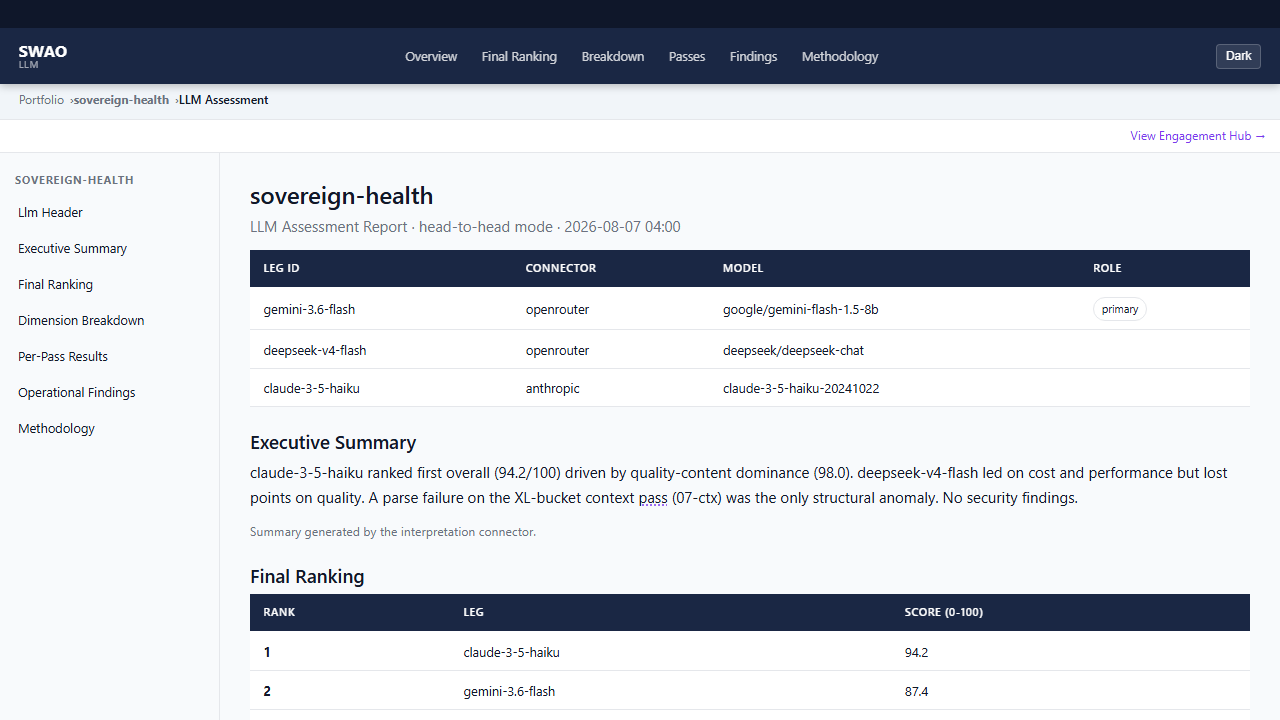 Ausschnitt aus der Publikation einer LLM-Bewertung für die Demo-Anwendung Sovereign Health: die verglichenen Legs, die Zusammenfassung und das Gesamtranking.
Weiterführende Seiten
- Überblick über die Bewertungstypen
- Anwendungsbewertung, Voraussetzung für die LLM-Bewertung
- LLM-Gateway-Konnektoren erstellen und LLM-Anbieter wechseln
- Lizenzverwaltung